
Фотографии документов, скриншоты и изображения с текстом часто нужно преобразовать в редактируемый формат. Переписывание вручную занимает много времени, поэтому удобнее использовать технологии распознавания текста – OCR (Optical Character Recognition). Такие инструменты автоматически анализируют изображение, выделяют текстовые элементы и переводят их в формат, подходящий для работы в редакторе Word.
Для успешного извлечения текста имеет значение качество исходного изображения. Чем выше разрешение, тем точнее результат. Размытые фото или сканы с наклоненным текстом распознаются хуже, поэтому перед обработкой стоит отсканировать или сфотографировать документ так, чтобы буквы были чёткими и не сжатыми.
Распознанный текст можно получить в разных форматах – TXT, RTF или сразу в DOCX. Чтобы перенести данные именно в Word, удобнее использовать инструменты, которые позволяют напрямую сохранять результат в формате .docx. Это исключает потерю форматирования и экономит время при редактировании.
Существуют онлайн-сервисы, настольные программы и встроенные функции Windows и мобильных приложений, которые позволяют извлечь текст за несколько кликов. Выбор зависит от того, работаете ли вы с единичным изображением или обрабатываете массив документов, где важна автоматизация и пакетное распознавание.
Использование встроенного распознавания текста в Microsoft OneNote
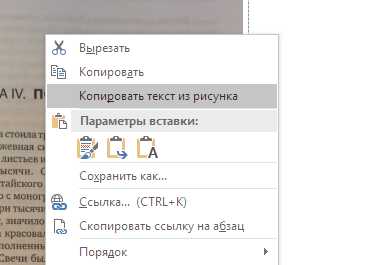
OneNote поддерживает функцию OCR, которая позволяет извлекать текст прямо из изображений, вставленных в заметку. Это упрощает перенос информации в Word без использования сторонних сервисов.
Порядок действий:
- Откройте OneNote и создайте новую страницу.
- Вставьте изображение с текстом через меню «Вставка» → «Рисунки».
- Щёлкните правой кнопкой мыши по изображению.
- Выберите «Копировать текст с рисунка».
- Вставьте скопированный текст в Word или в другую заметку.
При работе с многостраничными изображениями (например, сканами PDF) OneNote позволяет копировать текст со всех страниц сразу. Для этого используйте команду «Копировать текст со всех страниц рисунка».
Чтобы повысить точность распознавания:
- Используйте изображения с высоким разрешением.
- Избегайте размытых или перекошенных сканов.
- По возможности применяйте изображения с контрастным шрифтом и светлым фоном.
После вставки текста в Word рекомендуется проверить орфографию и форматирование, так как OCR может допускать ошибки при работе со сложными шрифтами или рукописными записями.
Применение функции сканирования текста через Google Drive

Google Drive позволяет преобразовать изображение с текстом в редактируемый документ без установки дополнительного ПО. Для этого используется встроенная технология распознавания текста (OCR), которая работает напрямую через сервис Google Документы.
Чтобы воспользоваться этой функцией, необходимо загрузить изображение в формате JPG, PNG или PDF в Google Drive. После загрузки выполняются следующие шаги:
- Нажмите правой кнопкой на файл с изображением.
- Выберите пункт «Открыть с помощью» и укажите «Google Документы».
- Через несколько секунд откроется новый документ, где над изображением будет размещён распознанный текст.
Распознанный текст можно редактировать, копировать и переносить в Microsoft Word. Для сохранения в формате Word используйте функцию «Файл» → «Скачать» → «Microsoft Word (.docx)».
Для повышения точности распознавания:
- Используйте изображения с чётким контрастом и хорошим освещением.
- Избегайте фотографий с наклонённым текстом – лучше отсканированные файлы.
- При работе с многостраничными документами объединяйте их в единый PDF перед загрузкой.
Этот способ особенно удобен для тех, кто работает с мобильного устройства: через приложение Google Drive можно сфотографировать документ и сразу распознать текст с сохранением в Word.
Извлечение текста с помощью онлайн-сервисов OCR
Онлайн-сервисы OCR позволяют быстро преобразовать изображение в редактируемый текст без установки дополнительного программного обеспечения. Достаточно загрузить файл и дождаться распознавания.
Для работы обычно поддерживаются форматы JPG, PNG и PDF. Многие сервисы распознают кириллицу, что особенно важно при обработке документов на русском языке. Перед загрузкой желательно проверить качество исходного изображения: четкость текста и отсутствие сильных искажений увеличат точность результата.
После обработки сервис предлагает скачать текст в формате DOCX или TXT. Если доступен вариант экспорта в Word, текст можно сразу редактировать без ручного копирования. При выборе сервиса стоит обращать внимание на ограничения: количество страниц, размер файла и наличие водяных знаков в бесплатной версии.
Некоторые сервисы позволяют дополнительно выбрать язык распознавания, что снижает вероятность ошибок. Если требуется регулярная работа с изображениями, имеет смысл использовать платформы с возможностью пакетной обработки и интеграции с облачным хранилищем.
| i2OCR | Бесплатный сервис, поддерживает более 100 языков, в том числе русский |
| OnlineOCR | Экспорт в Word и Excel, ограничение на количество страниц в бесплатном режиме |
| OCR.Space | Поддержка API и загрузки файлов до 5 МБ без регистрации |
Выбирая сервис, стоит учитывать баланс между удобством интерфейса, скоростью обработки и точностью распознавания. При обработке большого количества документов лучше сразу протестировать несколько решений и сравнить результат.
Работа с настольными программами для распознавания изображений
Альтернативой может служить Readiris, ориентированный на работу с крупными документами и интеграцию с облачными сервисами. Пользователю доступна функция пакетной обработки, что особенно полезно при регулярном сканировании текстов.
Для пользователей Linux часто используется Tesseract OCR. Это бесплатное приложение с открытым исходным кодом, которое отличается гибкой настройкой. Хотя интерфейс в нём отсутствует, программу можно дополнить графическими оболочками, такими как gImageReader, что делает процесс удобнее.
При выборе настольного решения стоит учитывать поддержку языков, точность сохранения форматирования и возможность экспорта результата в Word. Для документов с таблицами и сложной вёрсткой лучше подойдут коммерческие продукты, так как они лучше справляются с сохранением структуры. Если же требуется работа с большим количеством однотипных изображений, оптимальной будет программа с функцией автоматической пакетной обработки.
Использование мобильных приложений для сканирования текста
Современные смартфоны позволяют быстро преобразовать изображение с текстом в редактируемый формат без установки дополнительных программ на компьютер. Для этого используются мобильные приложения с функцией OCR, которые автоматически распознают символы и сохраняют их в файл.
Google Lens – одно из наиболее удобных решений. Достаточно навести камеру на документ, выделить нужный фрагмент и скопировать текст. Результат можно сразу вставить в Word или другой редактор.
Microsoft Lens интегрируется с OneDrive и Word. Сканированный текст можно открыть прямо в формате DOCX, что экономит время при работе с большим количеством документов.
CamScanner поддерживает распознавание на русском языке и позволяет сохранять результат в разных форматах, включая PDF и Word. Дополнительно доступна корректировка контрастности для повышения качества распознавания.
Adobe Scan автоматически выравнивает изображение, удаляет тени и улучшает читаемость текста. После обработки результат синхронизируется с облаком Adobe Document Cloud, что удобно при работе на разных устройствах.
При выборе приложения стоит учитывать точность распознавания на русском языке, возможность экспорта в DOCX и наличие синхронизации с облачными сервисами. Для быстрой работы с Word удобнее использовать решения от Google или Microsoft, так как они позволяют сразу получить текст в нужном формате.
Сохранение распознанного текста напрямую в Word

После завершения процесса OCR многие программы позволяют сразу экспортировать результат в формат Microsoft Word. Это снижает риск потери форматирования и ускоряет работу с документом. В настольных приложениях, таких как ABBYY FineReader или Adobe Acrobat, достаточно выбрать опцию «Сохранить как» и указать формат .docx. Программа автоматически перенесёт текст вместе с базовым оформлением и разметкой абзацев.
Онлайн-сервисы, например OnlineOCR или Smallpdf, также поддерживают прямой экспорт в Word. Пользователю нужно загрузить изображение, дождаться распознавания и выбрать «Скачать как Word». В большинстве случаев сохраняются шрифты и структура текста, хотя сложные таблицы или нестандартные элементы могут потребовать ручной корректировки.
Некоторые мобильные приложения, такие как Microsoft Lens и Google Keep, позволяют отправить распознанный текст напрямую в Word на устройстве. После сканирования достаточно выбрать «Экспорт в Word» или «Открыть в Word», и текст откроется в приложении с возможностью редактирования и сохранения на устройстве или в облаке OneDrive.
Для повышения точности переноса рекомендуется перед сохранением проверить текст на наличие ошибок OCR, особенно в документах с нестандартными шрифтами или сложной версткой. Если текст содержит изображения или таблицы, полезно использовать функцию «Сохранить с исходным форматированием», чтобы минимизировать ручную правку.
Проверка и корректировка распознанного текста после переноса

После переноса текста из изображения в Word следует внимательно проверить его на ошибки распознавания. OCR-технологии могут неправильно интерпретировать символы, особенно в случае нестандартных шрифтов, размытых или повреждённых изображений.
Начните с визуального сравнения текста с исходной картинкой. Обратите внимание на цифры, специальные символы, буквы с диакритическими знаками. Часто встречаются замены «0» на «О», «1» на «I» или «l».
Используйте встроенные функции Word: проверку орфографии и грамматики, поиск и замену повторяющихся ошибок. Для текстов с технической или специализированной лексикой добавьте соответствующие слова в словарь Word, чтобы уменьшить количество ложных предупреждений.
При работе с таблицами или списками убедитесь, что структура текста сохранилась корректно. Иногда OCR сливает строки или разбивает абзацы неправильно, что требует ручной корректировки.
Для больших объёмов текста полезно разбивать документ на разделы и проверять их поочерёдно. Это сокращает вероятность пропуска ошибок и упрощает корректировку формата и содержания.
Если исходное изображение низкого качества, рассмотрите повторное сканирование или использование другого OCR-сервиса с улучшенной поддержкой конкретного языка. После всех корректировок сохраните документ в формате Word для дальнейшей работы или печати.
Вопрос-ответ:
Какие программы лучше всего подходят для извлечения текста с изображений на компьютере?
Для настольного использования хорошо подходят программы с технологией OCR, такие как ABBYY FineReader, Readiris и Microsoft OneNote. Они позволяют загрузить изображение и получить текст в формате, который можно скопировать или сразу сохранить в Word. ABBYY FineReader отличается точным распознаванием текста даже на сложных документах, а OneNote удобен тем, что распознаёт текст прямо из вставленного изображения без отдельной установки программ.
Можно ли извлечь текст с фотографии на смартфоне без подключения к компьютеру?
Да, для этого существуют мобильные приложения с функцией OCR. Например, Microsoft Lens, Google Keep и Adobe Scan. Они позволяют сделать фото документа, распознать текст и экспортировать его в Word или другие форматы. Google Keep распознаёт текст прямо в заметке и позволяет скопировать его, а Microsoft Lens даёт возможность сохранить текст в файле Word сразу после обработки.
Как проверить корректность текста после распознавания с картинки?
После переноса текста в Word рекомендуется внимательно просмотреть документ на наличие ошибок, которые могут появиться из-за искажений на изображении или особенностей шрифта. Следует обратить внимание на опечатки, неверные символы и форматирование. В Word удобно использовать функции проверки орфографии и грамматики, а также сравнивать полученный текст с оригиналом, если точность критична.
Можно ли сразу сохранить распознанный текст в Word без промежуточного копирования?
Да, некоторые программы и приложения поддерживают прямой экспорт текста в Word. ABBYY FineReader, например, позволяет после распознавания выбрать опцию «Сохранить как Word». Microsoft Lens также предлагает сохранить результат сканирования напрямую в формате .docx. Это сокращает количество действий и сохраняет исходное форматирование документа в максимально приближенном виде.
Какие ошибки чаще всего возникают при распознавании текста с картинок?
Чаще всего появляются ошибки из-за плохого качества изображения, размытых или маленьких шрифтов, сложных фонов или нестандартных шрифтов. Проблемы могут возникнуть с переносом строк, заглавными буквами, символами вроде «1» и «l». Для снижения числа ошибок рекомендуется использовать изображения с хорошим разрешением, контрастным текстом и прямым положением документа, а после распознавания тщательно проверять текст перед сохранением.


