

Сканированные документы представляют собой изображения текста, поэтому простое открытие их в Word не делает текст редактируемым. Для перевода таких файлов в формат Word необходимо использовать технологии оптического распознавания символов (OCR). Программное обеспечение с поддержкой OCR позволяет преобразовать изображение текста в полноценный документ, сохраняя структуру и форматирование.
Выбор инструмента зависит от качества скана и объема документа. Для качественных сканов с четким текстом подходят как встроенные функции Microsoft Word, так и специализированные программы вроде ABBYY FineReader. Для документов с нестандартными шрифтами или сложными таблицами стоит использовать профессиональные OCR-решения, которые корректно распознают все элементы.
Процесс конвертации включает несколько этапов: проверка качества скана, запуск распознавания текста, редактирование полученного документа и сохранение его в формате Word (.docx). Важным этапом является корректировка ошибок распознавания, особенно если текст содержит цифры, формулы или специальные символы, поскольку автоматические алгоритмы OCR не всегда точно передают такие элементы.
Выбор подходящего OCR-приложения для распознавания текста
Для конвертации сканированных документов в формат Word критически важно выбрать OCR-приложение с высокой точностью распознавания текста и поддержкой нужного языка. На рынке доступны как облачные сервисы, так и локальные программы. Облачные решения, например Adobe Acrobat Online и Google Drive OCR, обеспечивают быстрый результат без установки, но требуют стабильного интернет-соединения и могут иметь ограничения на размер файла.
Локальные приложения, такие как ABBYY FineReader и Readiris, позволяют работать с большими объемами документов и сохраняют конфиденциальность данных. ABBYY FineReader отличается расширенными возможностями редактирования и точным сохранением структуры документа, включая таблицы, списки и шрифты. Readiris подходит для пакетной обработки сканов и интеграции с офисными приложениями.
При выборе OCR стоит учитывать формат исходного скана. Для текстовых документов с четкими шрифтами подойдет любое современное OCR-приложение. Для документов с рукописным текстом или низким качеством сканов лучше использовать приложения с функцией улучшения изображения и обучаемыми словарями. Также важно проверять возможность экспорта результата непосредственно в формат Word без потери форматирования.
Тестирование нескольких приложений на одном и том же скане позволит определить оптимальный инструмент для конкретной задачи. Для профессиональной работы рекомендуется отдавать предпочтение программам с регулярными обновлениями алгоритмов распознавания и поддержкой новых версий формата Word.
Подготовка сканированного документа для точного распознавания
Для успешного перевода сканированного документа в формат Word важна качественная подготовка исходного материала. Низкое разрешение, искажённые линии или фон с пятнами могут привести к ошибкам распознавания.
Основные шаги подготовки включают:
- Очистка документа: удалите скрепки, складки, пятна и пометки, которые могут мешать программе распознавания текста.
- Выбор правильного разрешения сканирования: оптимально использовать 300 dpi для текстовых документов. Для мелкого шрифта рекомендуется 400–600 dpi.
- Контраст и яркость: текст должен быть чётко отделён от фона. Излишняя тьма или светлые пятна снижают точность OCR.
- Выравнивание страницы: страницы должны быть отсканированы ровно, без наклона. Сканы под углом увеличивают количество ошибок при распознавании.
- Формат файла: для OCR предпочтительнее сохранять скан в формате TIFF или PNG, так как JPEG может создавать артефакты сжатия.
Дополнительно рекомендуется проверять сканированные страницы на наличие пропусков строк или частично обрезанных краев. Если документ содержит несколько колонок, важно отметить это при загрузке в OCR-систему, чтобы сохранить правильную структуру текста.
Следуя этим шагам, вы значительно повысите точность распознавания текста и уменьшите необходимость ручной правки после конвертации в Word.
Пошаговое сканирование с сохранением качества текста
Установите разрешение сканера на 300–600 dpi для текста и 200–300 dpi для документов с изображениями. Это обеспечивает оптимальный баланс между детализацией и размером файла.
Выберите цветовой режим «Черно-белый» для чистого текста или «Оттенки серого», если документ содержит графические элементы, чтобы улучшить читаемость и точность распознавания.
Перед сканированием выровняйте лист на стекле сканера, удалите пыль и складки. Это минимизирует искажения и блики, которые могут снизить точность OCR.
Используйте формат сохранения TIFF или PDF с максимальным качеством без сжатия, если планируется последующее распознавание текста. Эти форматы сохраняют детали и контуры букв.
Сканируйте каждую страницу отдельно, проверяя предварительный просмотр на наличие обрезанных краев и перекосов. При необходимости корректируйте положение документа на сканере.
Соблюдайте единообразие параметров сканирования для всего документа. Разные настройки на отдельных страницах создают сложности при автоматическом распознавании и форматировании в Word.
После сканирования используйте программное обеспечение для предварительной обработки: выравнивание страниц, повышение контраста текста, удаление шума и пятен. Это повышает точность распознавания до 98–99% для печатных документов.
Преобразование PDF или изображения в формат Word

Если исходный файл представлен в виде изображения, например JPG или PNG, оптимально использовать программы с поддержкой распознавания текста, такие как ABBYY FineReader или Microsoft OneNote. Эти приложения способны идентифицировать шрифты и расположение блоков текста, минимизируя ручную правку после конвертации.
Перед преобразованием важно проверить разрешение исходного скана. Оптимальное значение – от 300 dpi для текстовых документов. Ниже этого уровня OCR может пропускать отдельные символы или неправильно распознавать знаки препинания.
При работе с PDF стоит убедиться, что документ не защищен паролем и не является «сканом внутри PDF», иначе потребуется предварительное извлечение изображения страниц. Для массовой обработки удобно использовать пакетные функции OCR, которые позволяют конвертировать несколько файлов одновременно без потери качества.
После преобразования рекомендуется сверить итоговый Word-файл с оригиналом, особенно проверяя таблицы, формулы и заголовки, чтобы гарантировать точность переноса информации. При необходимости корректировки форматирования лучше выполнять в самом Word, избегая повторной конвертации, чтобы сохранить текстовую целостность.
Исправление ошибок распознавания и форматирования в Word
Ошибки форматирования включают неправильные отступы, лишние разрывы строк, слияние колонок или искажение таблиц. Исправляйте их через меню «Разметка страницы» и «Абзац»: корректируйте отступы, интервал между строками и выравнивание текста. Для восстановления структуры таблиц используйте функцию «Вставка таблицы» и вручную переносите данные из неправильно распознанной сетки.
В случаях, когда текст разделен на отдельные фрагменты или распознан слиянием слов, применяйте поиск и замену, чтобы быстро исправить повторяющиеся ошибки. Для крупных документов рекомендуется использовать макросы или скрипты, которые автоматизируют исправление часто встречающихся опечаток и форматирования.
Проверка стиля текста важна для сохранения читабельности. Используйте «Стили» для заголовков, списков и выделений, чтобы единообразно оформить документ. После всех исправлений проведите финальную проверку документа, уделяя внимание нумерации страниц, спискам и ссылкам, чтобы результат максимально соответствовал оригиналу сканированного документа.
Сохранение и проверка готового документа Word
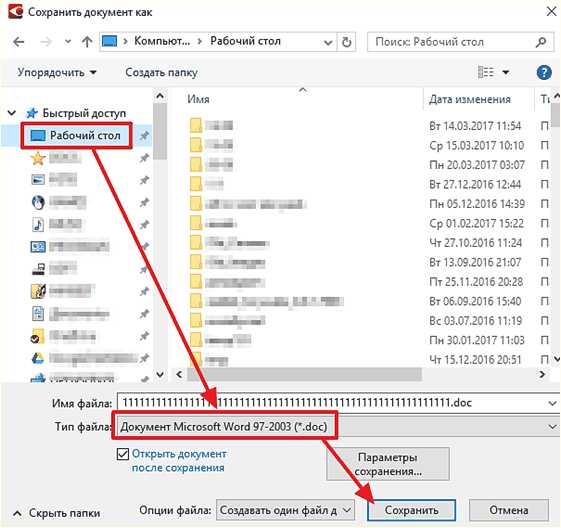
После завершения распознавания текста важно правильно сохранить документ, чтобы избежать потери данных и сохранить форматирование. Выберите формат .docx для полной совместимости с современными версиями Word. Если планируется дальнейшая работа с документом на разных устройствах или системах, создайте резервную копию в формате .pdf.
Перед сохранением проверьте весь текст на наличие ошибок распознавания. Используйте встроенную функцию проверки правописания и грамматики Word, а также режим «Найти и заменить» для исправления типичных ошибок, например, замену некорректных символов или лишних пробелов.
Особое внимание уделите таблицам, спискам и нумерованным абзацам. Часто после OCR элементы форматирования и порядок пунктов нарушаются. Сравните документ с оригиналом, чтобы убедиться в точности переноса данных и сохранении структуры.
При работе с изображениями или диаграммами убедитесь, что они корректно расположены и масштабированы. При необходимости отредактируйте размеры и обтекание текста, чтобы сохранить читаемость и аккуратность документа.
После всех проверок выполните финальное сохранение, желательно с новым именем файла, чтобы сохранить исходную версию. Это обеспечит возможность отката к оригиналу при обнаружении ошибок после дальнейшего редактирования.
Вопрос-ответ:
Какой формат сканированного документа лучше всего подходит для последующего преобразования в Word?
Для точного распознавания текста оптимально использовать форматы PDF или изображение высокого качества, например TIFF или PNG. PDF сохраняет структуру страниц, а TIFF/PNG минимизируют искажения текста. Избегайте JPEG с высокой степенью сжатия, так как это может привести к размытости символов и усложнить корректное распознавание.
Какие инструменты позволяют корректно распознать текст со сканированного документа?
Существует несколько видов программ и сервисов для распознавания текста. Среди наиболее удобных – приложения с функцией OCR, встроенные в офисные пакеты, отдельные программы для ПК, а также онлайн-сервисы. Важно выбирать инструмент, который поддерживает русский язык и умеет сохранять форматирование, чтобы таблицы, списки и абзацы переносились в Word с минимальными правками.
Как исправлять ошибки распознавания после конвертации скана в Word?
После преобразования документа важно внимательно проверить текст на опечатки и искажения. Чаще всего ошибки появляются в сложных шрифтах или при плохом качестве скана. Рекомендуется использовать встроенную проверку орфографии Word, а также вручную сверять цифры и специальные символы с оригиналом. В некоторых случаях приходится подправлять форматирование, особенно если документ содержит таблицы или формулы.
Можно ли перевести сканированный документ в Word без установки дополнительных программ?
Да, для этого существуют онлайн-сервисы, которые загружают скан или PDF и возвращают готовый документ в формате Word. Важно выбирать сервисы, которые сохраняют структуру документа и поддерживают русский язык. Недостатком онлайн-сервисов может быть ограничение размера файлов или необходимость подключения к интернету, но для разовых конверсий это удобно и быстро.


