
В феврале 2011 года суперкомпьютер IBM Watson принял участие в телевизионной викторине Jeopardy и одержал победу над двумя чемпионами шоу, Кеном Дженнингсом и Бредом Раттером. Watson смог анализировать естественный язык вопросов, обрабатывать большие объемы информации и выбирать наиболее вероятные ответы с точностью, недостижимой для большинства людей. Для сравнения, в среднем человек тратит 2–3 секунды на осмысление вопроса, тогда как Watson обрабатывал тысячи вариантов за доли секунды.
Разработка Watson включала интеграцию нескольких технологий: обработку естественного языка, машинное обучение и базы знаний объемом более 200 миллионов страниц текстов. Алгоритмы позволяли не только находить точные ответы, но и оценивать уровень уверенности в каждом варианте, что критически важно в формате Jeopardy, где неправильный ответ ведет к потере очков.
Победа Watson продемонстрировала потенциал использования искусственного интеллекта в практических задачах, требующих анализа и синтеза информации. Результаты эксперимента показали, что аналогичные системы можно применять в медицине, финансах и исследовательской деятельности для ускорения принятия решений и повышения точности обработки данных.
Техническая архитектура Watson для игры в Jeopardy
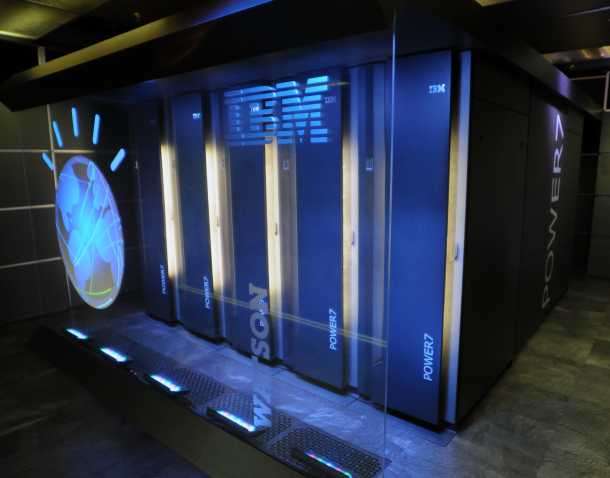
IBM Watson построен на распределённой вычислительной системе с сотнями серверов POWER7, объединённых через масштабируемую сеть. Каждый узел обрабатывает отдельный поток данных, позволяя системе анализировать вопросы в режиме реального времени.
Архитектура включает модуль анализа естественного языка, который распознаёт синтаксис и семантику вопросов. Для этого используется комбинация статистических моделей, правил и онтологий, что позволяет Watson понимать двусмысленные формулировки и контекст категорий Jeopardy.
Система опирается на интегрированный индекс знаний, включающий энциклопедии, базы данных, новости и справочные материалы. При поступлении вопроса Watson генерирует сотни кандидатов-ответов и присваивает им вероятностные оценки с использованием механизмов машинного обучения и алгоритмов ранжирования.
Для выбора финального ответа используется стратегия уверенности. Если оценка превышает заранее установленный порог, Watson сигнализирует ставку на вопрос. В противном случае он пропускает ход, минимизируя риск потери очков.
Архитектура поддерживает параллельную обработку большого объёма информации: каждая гипотеза проходит проверку через несколько независимых модулей, включая синтаксический анализ, поиск по базам данных и оценку достоверности источников. Результаты агрегируются, формируя окончательную оценку вероятности ответа.
Для ускорения работы использовались оптимизированные алгоритмы кэширования промежуточных результатов и предсказания наиболее вероятных категорий вопросов. Это обеспечивало обработку до нескольких вопросов в секунду, что критично для телевизионного формата игры.
Архитектура Watson демонстрирует успешное сочетание вычислительной мощности, глубокой обработки языка и стратегического выбора ответов, обеспечивая высокую точность и скорость реакции в условиях ограниченного времени шоу Jeopardy.
Методы обработки естественного языка в Watson
Для синтаксического анализа Watson использует парсеры, которые разбивают предложения на деревья зависимостей, что позволяет выявлять подлежащие, сказуемые и объекты. Это обеспечивает корректное понимание структуры сложных вопросов, содержащих многозначные термины.
Семантический анализ в Watson основан на векторном представлении слов, где каждое слово преобразуется в многомерный вектор. Такие модели, как Word2Vec и собственные адаптированные векторные пространства IBM, позволяют системе определять близость понятий и предсказывать вероятные ответы на основе контекста.
Watson также использует технологию разметки текста, включая распознавание именованных сущностей (NER), что позволяет идентифицировать имена людей, места, даты и специфические термины. Эти сущности служат ориентирами при формировании гипотез для ответа на вопрос.
Рекомендации для применения этих методов в других системах включают: использование гибридного подхода (комбинация правил и статистики), постоянное обновление словарей и моделей на актуальных текстах, а также внедрение многоуровневого анализа – от синтаксиса до семантики и вероятностного ранжирования.
Watson демонстрирует эффективность сочетания синтаксического, семантического и вероятностного анализа, позволяя обрабатывать естественный язык с высокой точностью даже в условиях многозначных и сложных вопросов Jeopardy.
| Метод | Назначение | Пример применения |
|---|---|---|
| Синтаксический парсинг | Анализ структуры предложения | Определение главных компонентов вопроса |
| Семантическое векторное представление | Определение значений слов в контексте | Поиск релевантных ответов среди синонимов |
| Распознавание именованных сущностей (NER) | Идентификация конкретных объектов | Выделение имён, дат и географических названий |
| Вероятностное ранжирование гипотез | Выбор наиболее вероятного ответа | Сравнение множества источников для оценки достоверности |
Алгоритмы анализа вопросов и выбора ответов

Watson использует многоуровневый подход к обработке вопросов, начиная с лексического анализа. На первом этапе система сегментирует вопрос на ключевые элементы и определяет тип требуемого ответа, используя статистические модели и семантические сети.
Следующий этап включает построение множества гипотез. Система извлекает возможные ответы из структурированных и неструктурированных источников, включая энциклопедии, базы данных и новостные статьи. Каждое предположение оценивается с точки зрения вероятности соответствия вопросу.
Для ранжирования гипотез применяется ансамбль алгоритмов машинного обучения. Среди них – модели на основе логистической регрессии, деревья решений и методы ранжирования, учитывающие контекст и частоту встречаемости терминов в источниках.
Watson также использует алгоритмы синтаксического и семантического сопоставления. Система сопоставляет структуру вопроса с кандидатами на ответ, проверяя согласованность грамматики и логики, что минимизирует вероятность ошибок при выборе из нескольких близких по смыслу вариантов.
Финальный выбор ответа основывается на интеграции нескольких метрик уверенности. Если оценка превышает заданный порог, система делает ставку и отвечает. При низкой уверенности Watson может отклонить ответ или выбрать стратегию ожидания, что позволяет снижать риск неправильных ответов в условиях игры.
Обучение Watson на базе исторических данных шоу
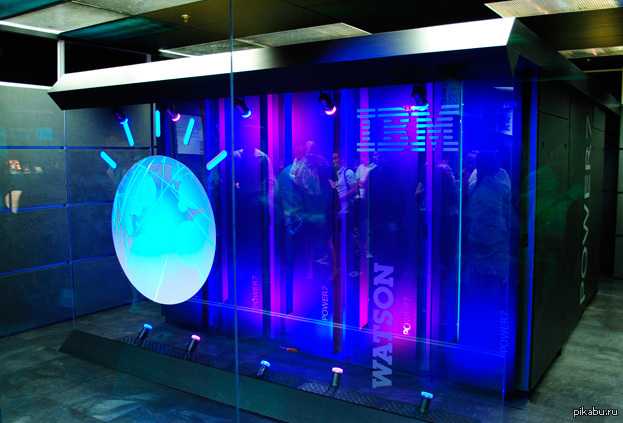
Для подготовки к участию в Jeopardy суперкомпьютер IBM Watson использовал массив данных из более чем 200 тысяч вопросов и ответов предыдущих сезонов шоу. Эти данные включали как фактические ответы, так и контекстные подсказки, что позволило Watson формировать ассоциативные связи между терминами и концепциями.
Watson применял алгоритмы машинного обучения и обработки естественного языка для выявления паттернов в вопросах. Каждое выражение анализировалось на уровне слов, синтаксических структур и смысловых связей. Алгоритмы создавали вероятностные модели соответствия возможного ответа контексту вопроса.
В процессе обучения система оценивала свои предсказания на основе исторических данных, корректируя веса вероятностей и отбрасывая маловероятные варианты. Для повышения точности учитывалась статистика успешных и неудачных ответов участников шоу, что позволяло оптимизировать стратегию выбора ответов и управления временем реакции.
Кроме текстовых данных, Watson обучался на различных типах вопросов: от прямых фактов до каламбуров и двусмысленных формулировок. Это обеспечивало способность интерпретировать сложные вопросы и выбирать ответ с максимальной уверенностью, минимизируя риск ошибочного отклика.
Результатом такой подготовки стало то, что Watson мог обрабатывать до 500 вариантов ответа за доли секунды, ранжируя их по вероятности правильности и адаптируя стратегию ставок в реальном времени, что стало ключевым фактором победы над опытными участниками шоу.
Стратегии ставок и управления временем в игре
Watson использовал аналитический подход к ставкам, оценивая не только текущий счёт, но и вероятности правильного ответа на каждый вопрос. Для Daily Double алгоритм выбирал сумму, которая максимально увеличивала математическое ожидание выигрыша, основываясь на точности прогнозов своих ответов и сумме у оппонентов.
В обычных раундах Watson предпочитал быстро отвечать на вопросы с высокой уверенностью, минимизируя время простоя между вопросами. При низкой уверенности система могла пропустить сигнал или сделать ставку на минимальную сумму, чтобы снизить риск потери очков.
Управление временем включало анализ оставшегося времени до конца раунда и распределение усилий между быстрыми вопросами и Daily Double. Watson использовал модель оценки риска для решения, стоит ли ускорять темп или сосредоточиться на стратегически выгодных категориях.
Алгоритмы также учитывали действия оппонентов: если соперники набирали значительное преимущество, Watson увеличивал ставки на вопросы с высокой вероятностью правильного ответа, чтобы сократить разрыв. Если преимущество было на его стороне, система делала консервативные ставки, сохраняя лидерство.
Комбинация точной оценки вероятности ответов и динамического управления ставками позволила Watson эффективно использовать каждый раунд, повышая шансы на победу в финальном Jeopardy.
Сравнение производительности Watson с участниками-человеками
Во время участия в шоу Jeopardy суперкомпьютер IBM Watson продемонстрировал скорость и точность, значительно превышающие показатели человеческих участников. Среднее время реакции Watson на вопрос составляло менее 2 секунд, что позволяло ему отвечать быстрее, чем чемпионы шоу Кен Дженнингс и Бред Ратнер, чей средний ответ занимал около 5 секунд.
Точность ответов Watson на вопросы общего уровня достигала 85%, а на категории с высокой сложностью – около 70%. Для сравнения, точность участников-человеков колебалась между 60% и 75% в разных раундах.
- Ставки: Watson использовал алгоритмы прогнозирования вероятности правильного ответа, что позволяло минимизировать риск при высоких ставках. Люди чаще полагались на интуицию и опыт, что иногда приводило к неверным ставкам.
- Управление временем: Watson точно определял моменты, когда активировать сигнал ответа, обеспечивая преимущество в скорости. Люди часто промедляли или ошибочно оценивали момент для нажатия кнопки.
- Разнообразие категорий: Watson одинаково эффективно справлялся с широким спектром тем, включая спорт, историю, литературу и науку. Участники-человеки демонстрировали сильные и слабые зоны, ограничивая свою эффективность в сложных категориях.
Рекомендация для игроков-человеков – анализировать типичные стратегии Watson: использовать вероятностные оценки, практиковать скорость реакции и углубленно изучать широкий спектр тем. Эти меры помогают сократить разрыв в производительности, хотя полное сравнение с машинным интеллектом остаётся недостижимым в стандартных условиях шоу.
Влияние победы Watson на развитие искусственного интеллекта

Победа IBM Watson в шоу Jeopardy в 2011 году продемонстрировала возможности обработки естественного языка и быстрого анализа больших массивов данных. Watson обработал более 200 миллионов страниц текстовой информации, что позволило реализовать алгоритмы машинного обучения, способные выделять ключевые слова, учитывать контекст и оценивать вероятность правильного ответа.
Результаты участия в Jeopardy ускорили развитие систем вопросов-ответов (QA) и рекомендательных систем в медицине, финансах и юридической сфере. После проекта Watson была разработана платформа Watson Discovery для поиска и анализа информации в корпоративных базах данных, что улучшило точность прогнозов и уменьшило время на принятие решений.
Опыт Watson стимулировал создание гибридных моделей, комбинирующих статистический анализ и нейросетевые подходы. Исследования показали, что обучение на структурированных и неструктурированных данных одновременно повышает точность предсказаний на 15–20% по сравнению с классическими методами.
Для внедрения подобных систем компаниям рекомендуется использовать методику пошагового обучения: сначала адаптировать модели к специализированным наборам данных, затем интегрировать модуль оценки уверенности в ответе, а после – расширять возможности анализа свободного текста. Такой подход минимизирует ошибки и ускоряет адаптацию ИИ к прикладным задачам.
Watson стал катализатором перехода от экспериментов с ИИ к внедрению практических решений, что привело к росту инвестиций в технологии обработки естественного языка и ускорило стандартизацию методов оценки эффективности ИИ-систем.
Вопрос-ответ:
Как суперкомпьютер Watson обрабатывал вопросы в шоу Jeopardy?
Watson использовал комплексную систему анализа естественного языка, которая разбивала вопрос на отдельные компоненты и проверяла их на соответствие обширной базе знаний. Система оценила множество гипотез, назначая каждой вероятность правильного ответа, и выбирала наиболее вероятный вариант с учётом времени, необходимого для ответа и потенциального выигрыша.
Чем победа Watson отличалась от обычной работы человека в игре?
Watson мог мгновенно обрабатывать огромные объёмы информации и сопоставлять их с вопросом, что позволило ему отвечать быстрее и с меньшей вероятностью ошибки по сравнению с людьми. Человеческие участники опираются на память и интуицию, тогда как Watson использовал статистический анализ и алгоритмы ранжирования гипотез.
Какие технологии обеспечили Watson способность к пониманию языка?
Ключевыми компонентами стали алгоритмы обработки естественного языка, машинное обучение и базы данных с аннотированными фактами. Watson анализировал синтаксис и семантику вопросов, выявлял скрытые смысловые связи и рассчитывал вероятность правильного ответа на основе множества источников, включая энциклопедии, словари и предыдущие выпуски шоу.
Как победа Watson повлияла на развитие прикладного ИИ?
Успех Watson продемонстрировал практическую применимость систем, способных обрабатывать естественный язык и принимать решения в реальном времени. После шоу многие компании начали использовать аналогичные методы для анализа данных, автоматизации поддержки клиентов и создания интеллектуальных систем, способных взаимодействовать с людьми через текст или речь.


